DeepSeek-V4.1-Flash:重磅开源 552B 超强多模态 MoE 模型(100万长上下文 / 显存暴降75%)
技术规格与参数矩阵
深度解析与项目背景
一、 这个大模型到底有多炸裂?(一分钟大白话看懂)
在 2026 年,大模型领域最让人头疼的两大现实痛点:一是超长上下文吃显存极其恐怖,处理一本几十万字的长文档或者让 AI 智能体连续编程几小时,显卡显存瞬间被撑爆;二是推理成本太贵、速度太慢,普通开发者和中小企业根本跑不起顶配模型。
DeepSeek(深度求索)今天正式重磅全球开源了全新的技术奇迹:DeepSeek-V4.1-Flash!
通俗用大白话解释,它把大模型技术的“成本极限”与“推理效率”推向了物理天花板:
- 这是一个总参数高达 552B(5520 亿)的高性能混合专家大模型(MoE),原生支持图片与文本的多模态端到端理解,支持高达 100 万 Token(约 200 万字)的超长上下文窗口;
- 最不可思议的是它的独创架构:在处理你发过去的长文本时,每次只激活 8B(80 亿)参数;在生成回复时也只激活 16B 参数!这意味着你只需要极低的算力成本,就能享受到 5520 亿大底模的超强逻辑与常识推理;
- 更强悍的是,它独创的 CSA2 与 FP4 缓存技术,把显存中缓存占用砍掉了整整 75%(相当于旧版 V4-Flash 的 1/4,一代的 1/437)!一举让普通多卡工作站甚至单台高配 Mac 本地运行 100 万上下文大模型成为了现实!
二、 为什么它能震撼整个 AI 圈?核心硬核亮点速览
- 💡 革命性 CED(因果编解码)架构:打破传统 Transformer 结构,在预填阶段(Prefill)仅激活 8B 参数,输出阶段仅激活 16B 参数,对智能体这种“输入巨长、输出精炼”的代码与巡检任务具有降维打击级的性价比;
- ⚡ 显存占用极限压缩至 890 字节/Token:搭配原生 FP4(E2M1)极限制精度的 KV Cache,让超长对话和长程代码生成的延迟大幅降低,API 调用费用仅为传统大模型的极小一部分;
- 🧠 原生 100 万 Token(1M)全景上下文:由 45T 庞大多模态语料直接预训练打通,无论是把整座代码仓库丢给它、还是喂整本行业分析年报与全套财报,都不存在丢失关键线索与上下文失忆;
- 🎛️ 独创 1~100 连续可调思考力度(Reasoning Effort):支持在调用 API 或本地运行时指定思考档位(1 到 100)。简单任务设为 10 秒级极速响应,极复杂数学与架构设计设为 100 触发深度链式思考;
- 🌐 顶级基准屠榜:在核心代码智能体榜单 Terminal-Bench 2.1 斩获 90.6%,在 DeepSWE 获得 74.2%,在开源模型中全面领跑!
三、 零基础小白保姆级极速上手(本地体验与一键部署)
即使你过去从未部署过大模型,跟着以下 4 步走,也能轻松接入体验:
- 第一步:通过 vLLM / SGLang 高性能引擎一键拉起本地服务
如果你的服务器或本地电脑配备了 Nvidia 显卡环境,直接在终端中运行以下标准命令:
# 1. 一键安装现代高性能推理框架 vLLM pip install vllm # 2. 一行命令直接启动 DeepSeek-V4.1-Flash 服务端 vllm serve "deepseek-ai/DeepSeek-V4.1-Flash" --port 8000 - 第二步:通过 Docker 容器一键免配置运行
不想配置 Python 环境?官方原生支持 Docker Model Runner 一键启动:
docker run --gpus all -p 8000:8000 hf.co/deepseek-ai/DeepSeek-V4.1-Flash - 第三步:在代码中调用标准 OpenAI 兼容接口
启动后,它会自动在本地开启标准的
http://localhost:8000/v1接口,你可以在任何日常软件(如 Chatbox、Cherry Studio、NextChat、Cursor)中当作原生 OpenAI 接口无缝使用:from openai import OpenAI client = OpenAI(base_url="http://localhost:8000/v1", api_key="none") # 发起带图片的多模态极速对话 response = client.chat.completions.create( model="deepseek-ai/DeepSeek-V4.1-Flash", messages=[ {"role": "user", "content": "请用通俗大白话解释量子力学,并写一段 Python 演示代码。"} ], temperature=1.0, top_p=0.95 ) print(response.choices[0].message.content) - 第四步:低配设备 / Mac 用户白嫖运行方案
如果是 Apple M 系列芯片的 Mac 电脑(如 M2/M3/M4),社区已经同步上线了 MLX 2-bit 量化版本,在 128G/256G 内存的 Mac Studio 上即可达到 9.5 tokens/sec 的流畅推理速度!直接在终端使用
pip install mlx-lm即可丝滑运行。
四、 小白常见踩坑排错清单(避坑必读)
- ⚠️ 常见问题 1:官方 API 调用时模型名称报错找不到?
➔ DeepSeek 官方 API 平台为了防止版本混乱,在云端接口统一使用deepseek-flash作为标准别名。旧版的deepseek-v4-flash已经平滑路由到最新的 4.1 版本,因此如果你在第三方工具中配置,模型名填写deepseek-flash即可完美生效。 - ⚠️ 常见问题 2:本地显存吃紧,长文本直接崩掉?
➔ 确认是否开启了 FP4 KV Cache 参数。在 vLLM 或 SGLang 启动参数中加入--kv-cache-dtype fp8或fp4,显存开销会立刻从几十 GB 压缩至几 GB;如果没有多张显卡,建议首选由 NVIDIA 官方压制的DeepSeek-V4.1-Flash-NVFP4量化版本。 - ⚠️ 常见问题 3:商业使用是否合规?有版权风险吗?
➔ 彻底放心!DeepSeek 官方在 Hugging Face 上明确采用极度宽松的 MIT 开源协议,无论是个人学习折腾、科研论文,还是直接用于商业产品与云服务集成,完全免费合规、零版权限制!
核心特性与亮点
- ✓总参数 552B,预填仅激活 8B、解码激活 16B,推理成本骤降
- ✓支持原生 100 万 Token 超长上下文与图片文本多模态理解
- ✓独创 CSA2 与 FP4 缓存,全局显存占用仅 890 字节/Token(降低75%)
- ✓完全遵循 MIT 开源协议,支持商业化使用与本地量化部署
快速部署 / 运行命令
pip install vllm && vllm serve "deepseek-ai/DeepSeek-V4.1-Flash"立即开始使用
直达官方原厂网站或 GitHub 开源仓库
延伸探索 · 猜你喜欢
同类热门开源神器与硬核工具推荐
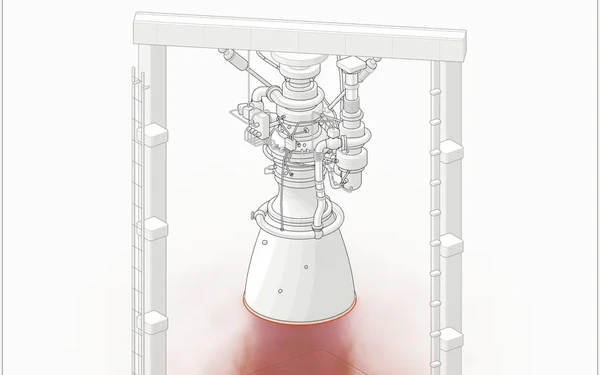
Anatomy:让 AI 编程助手将复杂技术概念雕刻成交互式 3D 机械剖面图的现象级开源神器
GitHub 狂揽 14.3k Stars 的现象级 Agent 视觉神器!专为 Claude Code、Codex 打造。一句提示词即可将抽象算法与系统架构自动雕刻成由数十个精密零件组成的等轴测交互式机械实体模型(SVG + WebGL Shader),支持零件动态分离与光影交互。
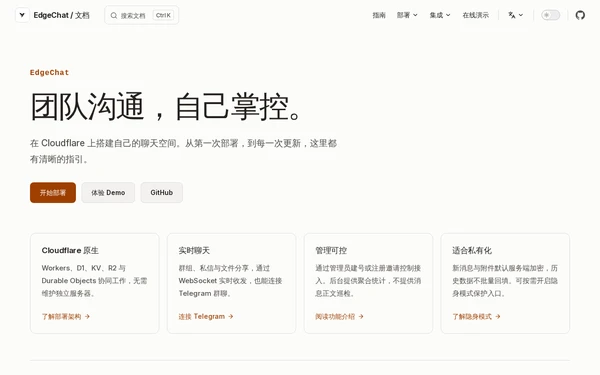
Edgechat:0服务器成本!基于 Cloudflare Workers 的开源自托管聊天系统(Telegram 双向桥接 / 加密通信)
彻底告别租云服务器!完全运行在 Cloudflare 边缘的现代化团队聊天系统。支持实时群聊私聊、语音与文件分享,原生双向打通 Telegram 群组,消息与附件 AES-256 服务端强加密,永久 0 运维费用。